Belajar Bahasa Pemrograman R: Vector, List, Data Frame, Matriks, Array, dan Factor
Kupas tuntas 6 struktur data fundamental di R: subsetting vektor tingkat lanjut, manipulasi nested list & functional programming, data wrangling tabel Data Frame, operasi aljabar linier matriks, hingga pemodelan faktor kategorikal.
Dalam rekayasa data dan komputasi statistik, keberhasilan suatu analisis tidak hanya ditentukan oleh algoritma pemodelan yang canggih, melainkan bagaimana data tersebut diorganisasikan dalam memori. Pemilihan struktur data yang tepat berdampak langsung pada efisiensi ruang (space complexity) dan kecepatan eksekusi (time complexity).
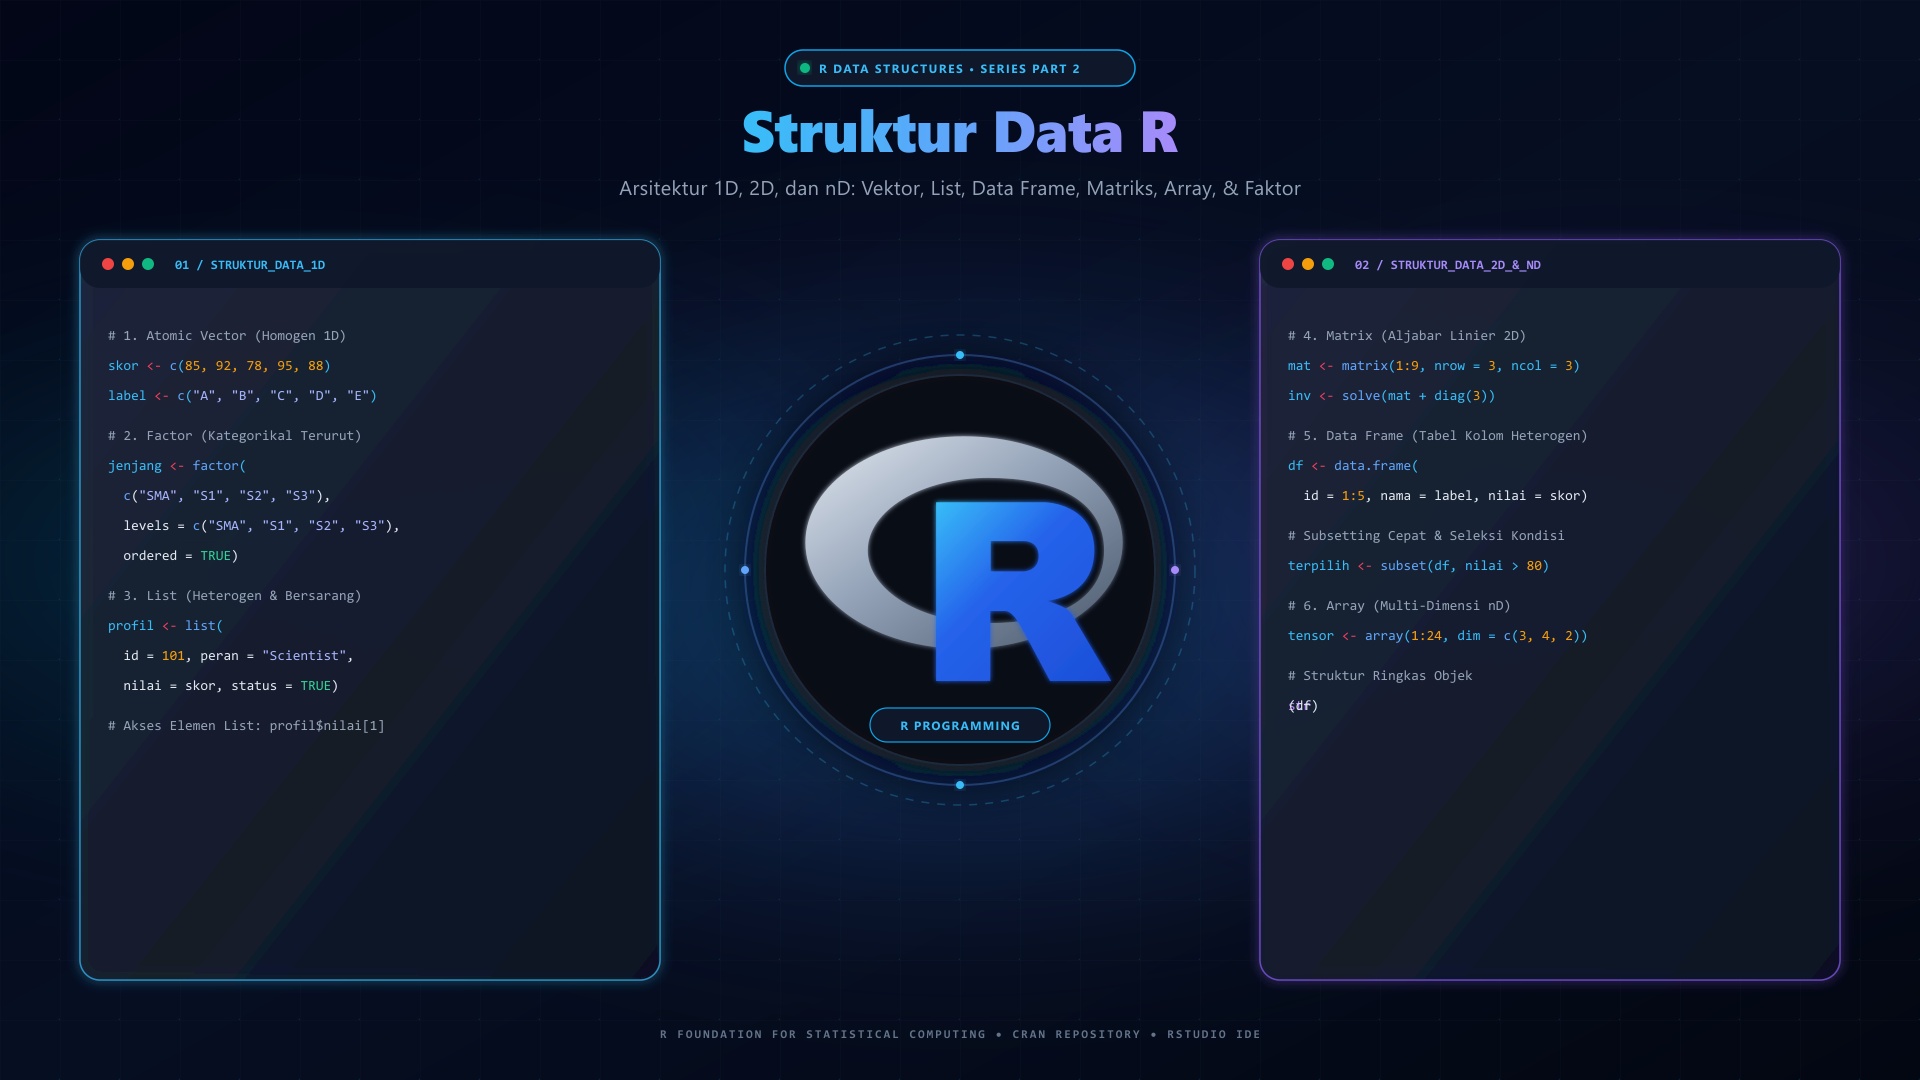
Bahasa R memiliki rancangan struktur data yang unik, sistematis, dan dirancang khusus untuk mempermudah kalkulasi berbasis vektor (vectorized computation). Secara mendasar, struktur data di R diklasifikasikan ke dalam dua dimensi utama:
- Jumlah Dimensi: 1 Dimensi (1D), 2 Dimensi (2D), atau Multi-Dimensi (D).
- Karakteristik Tipe Data:
- Homogen: Semua elemen di dalamnya wajib memiliki tipe data yang sama (misalnya angka semua atau teks semua).
- Heterogen: Elemen di dalamnya dapat menampung beragam tipe data yang berbeda sekaligus.
Berikut adalah peta taksonomi struktur data di R yang menjadi panduan utama kita:
| Dimensi | Tipe Homogen (Tipe Data Seragam) | Tipe Heterogen (Aneka Ragam Tipe Data) |
|---|---|---|
| 1 Dimensi (1D) | Atomic Vector | List |
| 2 Dimensi (2D) | Matrix | Data Frame |
| Multi-Dimensi (D) | Array | (Daftar Bersarang / Nested Lists) |
| Kategorikal Khusus | Factor (Vektor dengan atribut levels) | - |
Mari kita bedah keenam struktur data tersebut secara tuntas beserta teknik manipulasi tingkat menengahnya.
1. Vektor (Vectors): Fondasi 1 Dimensi Homogen
Vektor adalah struktur data paling mendasar di R. Karakteristik utamanya adalah satu dimensi dan homogen.
# Deklarasi vektor numerik
skor <- c(75, 82, 90, 68, 85)

# Deklarasi vektor teks (character)
komoditas <- c("Kopi", "Kakao", "Sawit", "Karet")

# Deklarasi vektor boolean (logical)
status_aktif <- c(TRUE, FALSE, TRUE, TRUE)
Penanganan Nilai Hilang (Missing Values / NA)
Dalam analisis dunia nyata, data kotor atau nilai yang hilang sering ditemukan. R melambangkan nilai yang tidak tersedia dengan simbol khusus NA (Not Available):
data_usia <- c(24, 31, NA, 45, 29)

# Vektor berlabel (named vector) dengan format nama = nilai
harga_buah <- c(apel = 25000, jeruk = NA, mangga = 18000, pisang = 12000)
print(harga_buah)
#   apel   jeruk  mangga  pisang
#  25000      NA   18000   12000
Teknik Subsetting Vektor Tingkat Lanjut
Untuk mengekstrak elemen tertentu dari sebuah vektor, R menyediakan tiga pendekatan subsetting:
1. Indeks Positif (Positive Indexing)
Memilih elemen berdasarkan nomor urut posisinya (ingat bahwa R menganut 1-based indexing):
katalog <- c("Laptop", "Monitor", "Keyboard", "Mouse", "Headset")

# Mengambil elemen ke-2
katalog[2]
# [1] "Monitor"

# Mengambil elemen ke-1 dan ke-4 sekaligus
katalog[c(1, 4)]
# [1] "Laptop" "Mouse"
2. Indeks Negatif (Negative Indexing)
Mengecualikan (drop) elemen pada posisi tertentu dan mempertahankan sisanya:
# Mengambil seluruh elemen KECUALI elemen pertama
katalog[-1]
# [1] "Monitor"  "Keyboard" "Mouse"    "Headset"

# Mengecualikan elemen ke-1 sampai ke-3
katalog[-c(1:3)]
# [1] "Mouse"   "Headset"
3. Subsetting Berbasis Logika & Pola Teks (Logical Subsetting)
Ini adalah pendekatan paling bertenaga, di mana kita memfilter vektor berdasarkan evaluasi kondisi boolean atau ekspresi reguler:
# Mengambil nama barang yang panjang karakternya lebih dari 6
katalog[nchar(katalog) > 6]
# [1] "Monitor"  "Keyboard" "Headset"

# Mengambil barang yang mengandung huruf 'o'
katalog[grepl("o", katalog)]
# [1] "Laptop"   "Monitor"  "Keyboard" "Mouse"

# Kombinasi multi-kondisi: berawalan 'M' ATAU berakhiran 't'
katalog[grepl("^M", katalog) | grepl("t$", katalog)]
# [1] "Monitor"  "Mouse"    "Headset"
Operasi Matematika & Ringkasan Statistik Vektor
R dirancang untuk kalkulasi vektor terdistribusi. Seluruh fungsi statistik dasar dapat langsung diaplikasikan:
sampel_angka <- c(12, 18, 25, 9, 32, 18, 45)

max(sampel_angka)      # Nilai maksimum: [1] 45
min(sampel_angka)      # Nilai minimum: [1] 9
range(sampel_angka)    # Rentang nilai: [1]  9 45
length(sampel_angka)   # Total elemen: [1] 7
sum(sampel_angka)      # Jumlah total: [1] 159
prod(sampel_angka)     # Hasil kali seluruh elemen: [1] 427248000
mean(sampel_angka)     # Rata-rata (mean): [1] 22.71429
median(sampel_angka)   # Nilai tengah (median): [1] 18
sd(sampel_angka)       # Standar deviasi: [1] 12.566
var(sampel_angka)      # Varians sampel: [1] 157.9048
sort(sampel_angka)     # Mengurutkan dari terkecil ke terbesar: [1]  9 12 18 18 25 32 45
Pembuatan Deret Bilangan (Sequences)
Untuk menghasilkan deret angka berurutan secara otomatis:
# Deret berurutan sederhana dengan operator titik dua (:)
1:8          # [1] 1 2 3 4 5 6 7 8
5:-2         # [1]  5  4  3  2  1  0 -1 -2

# Menggunakan fungsi seq() dengan interval kustom
seq(1, 25, by = 4)
# [1]  1  5  9 13 17 21 25

# Menghasilkan jumlah elemen pasti dengan pembagian jarak yang seragam
seq(0, 100, length.out = 5)
# [1]   0  25  50  75 100

# Pengulangan nilai menggunakan rep()
rep(10, times = 4)
# [1] 10 10 10 10

# Deret Geometri dengan perkalian kumulatif cumprod()
rasio <- 3
n_suku <- 5
deret_geometri <- cumprod(rep(rasio, n_suku))
# [1]   3   9  27  81 243
2. List: Wadah 1 Dimensi yang Fleksibel & Heterogen
Jika vektor adalah deretan kotak yang hanya boleh diisi barang sejenis, maka List adalah lemari serbaguna. List dapat menyimpan elemen dengan berbagai macam tipe dan struktur data sekaligus—termasuk menyimpan vektor, data frame, atau list lain di dalamnya.
# Membuat list heterogen
koleksi_data <- list(
  batch_id = 101L,
  metrik = "Temperatur Ruang",
  bacaan = c(24.5, 25.1, 24.8, 26.0),
  aktif = TRUE
)
Memahami Perbedaan Aksesor: [ ] vs [[ ]] vs $
Kesalahan paling umum pemula di R adalah tertukar antara kurung siku tunggal dan ganda:
- Kurung Siku Tunggal
list[i]: Mengembalikan sub-list (tetap berbentuk list pembungkus). - Kurung Siku Ganda
list[[i]]: Membuka pembungkus dan mengekstrak elemen aslinya secara langsung. - Operator Dollar
list$nama: Mengakses elemen berdasarkan label namanya.
# Mengakses dengan kurung siku tunggal -> hasilnya tetap bertipe list
koleksi_data[2]
# $metrik
# [1] "Temperatur Ruang"

# Mengakses dengan kurung siku ganda -> hasilnya bertipe character
koleksi_data[[2]]
# [1] "Temperatur Ruang"

# Mengakses menggunakan nama atribut
koleksi_data$bacaan[1]
# [1] 24.5
Memanipulasi Isi List
# Mengubah nilai atribut
koleksi_data$batch_id <- 205L

# Menambahkan elemen baru ke dalam list
koleksi_data$lokasi <- "Laboratorium A"

# Menambahkan elemen pada posisi urutan tertentu dengan append()
koleksi_data <- append(koleksi_data, list(peneliti = "Dr. Hartono"), after = 1)

# Menghapus elemen dari list: tetapkan nilainya menjadi NULL
koleksi_data$lokasi <- NULL
Nested Lists (List Bersarang)
List bersarang sangat ideal untuk menampung data berhirarki, serupa dengan struktur JSON pada API modern:
organisasi <- list(
  divisi = "Analytics & Research",
  anggota = list(
    list(id = 1, nama = "Ari", peran = "Data Scientist"),
    list(id = 2, nama = "Bella", peran = "BI Analyst")
  ),
  kantor = "Gedung Keuangan Jakarta"
)

# Mengakses nama anggota kedua di dalam sub-list
organisasi$anggota[[2]]$nama
# [1] "Bella"
Functional Programming: lapply() vs sapply()
Daripada menulis perulangan for manual untuk memproses setiap elemen list, R menyediakan keluarga fungsi *apply:
lapply(): Menerapkan fungsi ke setiap elemen dan selalu mengembalikan hasil dalam bentuk list.sapply(): Mengaplikasikan fungsi dan otomatis menyederhanakan (simplify) hasilnya menjadi vektor numerik jika memungkinkan.
data_grup <- list(kelas_a = 1:5, kelas_b = 6:10, kelas_c = 11:15)

# Menggunakan lapply() -> menghasilkan list
lapply(data_grup, mean)
# $kelas_a: [1] 3
# $kelas_b: [1] 8
# $kelas_c: [1] 13

# Menggunakan sapply() -> menghasilkan vektor ringkas bernama
sapply(data_grup, mean)
# kelas_a kelas_b kelas_c
#       3       8      13
3. Data Frames: Standar Emas Tabel Analisis 2 Dimensi
Data Frame adalah struktur data tabular dua dimensi yang paling banyak digunakan dalam analisis data. Di bawah kap mesin R, sebuah data frame sejatinya adalah list berdimensi sama, di mana setiap kolom adalah vektor dengan panjang yang identik.
Karakteristik penting:
- Antarkolom dapat memiliki tipe data yang berbeda (misalnya Kolom A teks, Kolom B angka).
- Di dalam satu kolom yang sama, semua baris wajib memiliki tipe data seragam.
# Membuat DataFrame secara manual
mahasiswa_df <- data.frame(
  id = 1:4,
  nama = c("Andi", "Budi", "Citra", "Dian"),
  usia = c(20, 22, 21, 23),
  ipk = c(3.75, 3.40, 3.92, 3.65),
  stringsAsFactors = FALSE
)
Membaca Data dari Berkas Eksternal (read.csv)
Dalam praktiknya, data biasanya dimuat dari berkas tabular atau URL:
# Memuat data siswa dari repositori eksternal
url_data <- "https://raw.githubusercontent.com/ekotwidodo/Kanwil-DJPb-Data-Analytics-2024/main/students.csv"
students_df <- read.csv(url_data)

# Melihat ringkasan struktur dan dimensi tabel
dim(students_df)    # [1] 20  4 (20 baris, 4 kolom)
str(students_df)    # Struktur tipe data setiap kolom
head(students_df, 3) # Melihat 3 baris teratas
Akses Baris, Kolom, dan Filter Kondisional
Sistem koordinat data frame menggunakan format df[baris, kolom]:
# 1. Mengakses Kolom tertentu sebagai Vektor
students_df$nama
students_df[, "nama"]
students_df[["nama"]]

# 2. Mengakses Baris tertentu
students_df[1, ]       # Mengambil seluruh kolom pada baris ke-1
students_df[1:3, ]     # Mengambil baris ke-1 hingga ke-3

# 3. Mengakses Elemen Sel Tertentu
students_df[2, 3]      # Baris 2, Kolom 3

# 4. Filter Berdasarkan Kriteria Logika (Subsetting Baris)
# Mengambil mahasiswa yang berusia di atas 30 tahun
senior_df <- students_df[students_df$usia > 30, ]

# Filter multi-kondisi: usia > 25 DAN jurusan Manajemen
manajemen_senior <- students_df[students_df$usia > 25 & students_df$jurusan == "Manajemen", ]
Transformasi & Wrangling Data Frame
# A. Menambahkan Kolom Baru
students_df$kategori_usia <- ifelse(students_df$usia >= 30, "Senior", "Junior")

# B. Menambahkan Baris Baru dengan rbind()
data_baru <- data.frame(
  id = 21,
  nama = "Untung",
  usia = 41,
  jurusan = "Bisnis",
  kategori_usia = "Senior"
)
students_df <- rbind(students_df, data_baru)

# C. Mengurutkan Data Frame dengan order()
# Mengurutkan tabel berdasarkan usia dari termuda ke tertua
students_terurut <- students_df[order(students_df$usia), ]

# D. Menggabungkan Dua Data Frame secara Relasional dengan merge()
# Misalkan ada data IPK terpisah berbasis ID:
nilai_ipk <- data.frame(id = 1:21, ipk = round(runif(21, 3.2, 4.0), 2))

# Inner join / Full outer join berbasis kunci 'id'
tabel_lengkap <- merge(students_df, nilai_ipk, by = "id", all = TRUE)

# E. Agregasi Statistik Berdasarkan Grup dengan aggregate()
# Menghitung rata-rata usia per jurusan:
rata_usia_jurusan <- aggregate(usia ~ jurusan, data = tabel_lengkap, FUN = mean)
print(rata_usia_jurusan)
4. Matriks (Matrices): Tabel 2 Dimensi Homogen
Matriks adalah tabel baris dan kolom yang wajib homogen (semua elemen memiliki tipe data yang sama). Matriks adalah tulang punggung komputasi aljabar linier, pengolahan citra (image processing), dan algoritma machine learning.
Pembuatan Matriks
# Membuat matriks 3x3 dari vektor angka 1 sampai 9
# Default pengisian di R adalah berbasis kolom (column-wise)
mat_a <- matrix(1:9, nrow = 3, ncol = 3)

# Pengisian berbasis baris dengan argumen byrow = TRUE
mat_b <- matrix(1:9, nrow = 3, ncol = 3, byrow = TRUE)
print(mat_b)
#      [,1] [,2] [,3]
# [1,]    1    2    3
# [2,]    4    5    6
# [3,]    7    8    9

# Menggabungkan vektor menjadi matriks berdasarkan kolom (cbind) atau baris (rbind)
v1 <- c(10, 20, 30)
v2 <- c(40, 50, 60)
mat_gabung <- cbind(v1, v2)
Operasi Aljabar Linier Matriks
Perhatikan perbedaan penting antara operator perkalian elemen dengan perkalian matriks sejati:
m1 <- matrix(c(4, 2, 3, 1), nrow = 2)
m2 <- matrix(c(1, 2, 3, 4), nrow = 2)

# 1. Penjumlahan & Pengurangan (Element-wise)
m_tambah <- m1 + m2
m_kurang <- m1 - m2

# 2. Perkalian Element-wise (*)
m_elemen <- m1 * m2

# 3. Perkalian Matriks Aljabar Linier / Dot Product (%*%)
# Syarat: Jumlah kolom matriks pertama harus sama dengan jumlah baris matriks kedua
m_dot <- m1 %*% m2
print(m_dot)
#      [,1] [,2]
# [1,]   10   24
# [2,]    4   10

# 4. Transpose Matriks t()
m_trans <- t(m1)

# 5. Determinan Matriks det()
m_det <- det(m1)   # [1] -2

# 6. Invers Matriks Persegi dengan solve()
# Invers matriks A didefinisikan sedemikian rupa sehingga A %*% solve(A) = Matriks Identitas
m_inv <- solve(m1)
print(m_inv)
#      [,1] [,2]
# [1,] -0.5  1.5
# [2,]  1.0 -2.0
5. Array: Struktur Data Tensor Multi-Dimensi (D)
Jika matriks dibatasi hanya memiliki 2 dimensi (baris kolom), maka Array adalah ekstensi multi-dimensi dari matriks. Setiap elemen dalam array juga harus homogen.
Array sering digunakan untuk merepresentasikan data spasial, data deret waktu panel multi-variabel, atau citra RGB (tinggi lebar 3 kanal warna).
# Membuat array 3 dimensi berukuran 3x3x2
# (3 baris, 3 kolom, dan 2 lapisan / layer)
tensor_3d <- array(1:18, dim = c(3, 3, 2))
print(tensor_3d)
# , , 1
#      [,1] [,2] [,3]
# [1,]    1    4    7
# [2,]    2    5    8
# [3,]    3    6    9
#
# , , 2
#      [,1] [,2] [,3]
# [1,]   10   13   16
# [2,]   11   14   17
# [3,]   12   15   18
Mengakses dan Memotong (Slicing) Array
# Mengakses elemen spesifik: Baris 2, Kolom 3, Lapisan 1
tensor_3d[2, 3, 1]
# [1] 8

# Mengekstrak seluruh lapisan ke-2 sebagai matriks 2D
matriks_lapis_2 <- tensor_3d[, , 2]

# Mengonversi seluruh tensor kembali menjadi vektor 1D
vektor_datar <- as.vector(tensor_3d)
6. Faktor (Factors): Menangani Data Kategorikal & Pemodelan Statistik
Faktor adalah struktur data khusus di R yang digunakan untuk merepresentasikan variabel kategorikal (nominal maupun ordinal). Berbeda dengan vektor karakter biasa, faktor menyimpan dua komponen utama:
- Nilai data bilangan bulat (integer codes) di balik layar.
- Daftar label kategori unik (levels).
Faktor Nominal vs Ordinal
# 1. Faktor Nominal (Kategori tanpa tingkatan hierarki)
gender <- factor(c("Pria", "Wanita", "Wanita", "Pria", "Wanita"))
levels(gender)
# [1] "Pria"   "Wanita"

# 2. Faktor Ordinal (Kategori dengan urutan tingkatan berjenjang)
jenjang_studi <- factor(
  c("SMA", "S1", "S2", "S1", "S3", "SMA", "S2"),
  levels = c("SMA", "S1", "S2", "S3"),
  ordered = TRUE
)
print(jenjang_studi)
# [1] SMA S1  S2  S1  S3  SMA S2
# Levels: SMA < S1 < S2 < S3
Mengapa Faktor Sangat Krusial dalam Model Statistik?
Ketika Anda memasukkan variabel faktor ke dalam fungsi pemodelan seperti lm() (linear regression) atau glm() (logistic regression), R secara otomatis mengonversinya menjadi variabel boneka (dummy variables):
data_gaji <- data.frame(
  gaji_juta = c(6.5, 9.0, 14.5, 8.5, 22.0, 5.8, 15.0),
  jenjang = factor(c("SMA", "S1", "S2", "S1", "S3", "SMA", "S2"),
                   levels = c("SMA", "S1", "S2", "S3"))
)

# Membangun model regresi linear
model_regresi <- lm(gaji_juta ~ jenjang, data = data_gaji)
summary(model_regresi)
Dalam ringkasan model di atas, R secara otomatis menetapkan level pertama (SMA) sebagai kategori referensi (baseline reference). Koefisien untuk jenjangS1, jenjangS2, dan jenjangS3 mengukur peningkatan rata-rata gaji relatif terhadap lulusan SMA.
Hati-Hati Saat Mengonversi Faktor ke Numerik!
Jika Anda memiliki faktor angka sepertif <- factor(c(10, 20, 30))dan menjalankanas.numeric(f), R akan mengembalikan indeks levelnya (1, 2, 3), bukan angka aslinya!
Cara aman mengonversi nilai asli faktor angka:as.numeric(as.character(f)).
7. Rangkuman & Panduan Memilih Struktur Data
| Kasus Kebutuhan Anda | Struktur Data Terbaik | Alasan Penggunaan |
|---|---|---|
| Menyimpan urutan angka suhu harian | Atomic Vector | Ringan, 1D, operasi matematika otomatis tervektorisasi |
| Menyimpan respons JSON API profil pengguna | List | Dapat menampung campuran teks, tanggal, vektor, dan tabel |
| Mengolah tabel transaksi penjualan bulanan | Data Frame | Format tabel 2D ideal, mendukung kolom teks, tanggal, dan angka |
| Komputasi dekomposisi nilai eigen (PCA) | Matrix | 2D homogen, mendukung operasi aljabar linier %*% dan solve() |
| Analisis citra citra multispektral satelit | Array | Struktur tensor multi-dimensi D berkinerja tinggi |
| Mengelompokkan responden survei tingkat kepuasan | Factor (Ordered) | Menyimpan urutan kategori untuk regresi dan uji Chi-Square |
Dengan menguasai keenam struktur data ini, Anda kini memiliki pemahaman arsitektural yang utuh terhadap bagaimana R memproses dan menyimpan informasi di dalam memori. Fondasi ini akan membuat transisi Anda ke pustaka modern seperti dplyr, tidyr, dan data.table menjadi jauh lebih alami dan intuitif.
Related Articles
More writings on Data Science and related technologies.
Belajar Bahasa Pemrograman R: Visualisasi Data dengan Library ggplot2, Patchwork, dan Diagram Lanjutan
Kuasai ekosistem visualisasi modern di R berbasis Grammar of Graphics: eksplorasi mendalam ggplot2 dari konsep layering geom_*, faceting, custom theme, komposisi multi-plot dengan patchwork, hingga diagram aliran data tingkat lanjut (Sankey & Chord Diagram).
Belajar Bahasa Pemrograman R: Visualisasi Data dengan Plot, Barplot, dan Multiplot Layout
Pelajari seni visualisasi data menggunakan sistem grafik dasar (base graphics) di R: eksplorasi mendalam fungsi plot(), barplot(), pie(), hist(), boxplot(), hingga perancangan dashboard multi-plot 2x2 dengan studi kasus nyata.